Seedance 2.5: cómo escribir el prompt para un video de IA sin fotos de referencia
La mayoría de los generadores de video con IA necesitan una imagen de referencia. Seedance 2.5 no — pero eso significa que todo el trabajo de dirección recae en el prompt. Así es como lo estructuramos.
- n8n
- HubSpot
- Slack
- Notion
- OpenAI
- Zapier
- QuestionPro
- SalesSheets
- Smile
El problema real: piden el prompt, no el video
Publicamos en LinkedIn un video de 13 segundos generado con Seedance 2.5. No hubo cámara, actores ni fotos: solo un prompt de texto. La reacción fue buena, pero la pregunta que se repitió en los comentarios fue siempre la misma: ¿cuál fue el prompt?
Esa pregunta tiene sentido. Con los generadores de video que parten de una foto, el reto es conseguir la imagen correcta. Con Seedance 2.5 el reto se mueve por completo al lenguaje: no hay nada que "anclar" visualmente, así que el prompt tiene que hacer todo el trabajo de dirección.
Qué hace distinto a Seedance 2.5
La mayoría de las herramientas de video con IA son imagen-a-video: subes una foto de referencia y el modelo la anima. Seedance 2.5, de Higgsfield, trabaja en modo texto-a-video puro — genera el clip completo a partir de una descripción escrita, sin ninguna imagen de entrada.
Eso es una ventaja cuando no tienes el activo visual correcto (o no quieres mostrar una cara real). Pero también sube la dificultad: el modelo tiene que inventar y mantener consistente todo lo que normalmente heredaría de una foto — el rostro, la ropa, el entorno — solo a partir de tus palabras.
Por qué es más difícil sin foto de referencia
Sin una imagen ancla, cada elemento del prompt es una decisión que el modelo puede interpretar distinto si no se la dejas explícita. El síntoma más común es la inconsistencia: el personaje cambia ligeramente de un segundo a otro, el encuadre salta, la iluminación no es coherente con la escena descrita.
Cuanto más vago el prompt, más "libertad creativa" toma el modelo entre toma y toma — y esa libertad casi nunca juega a tu favor.
La anatomía de un prompt que funciona
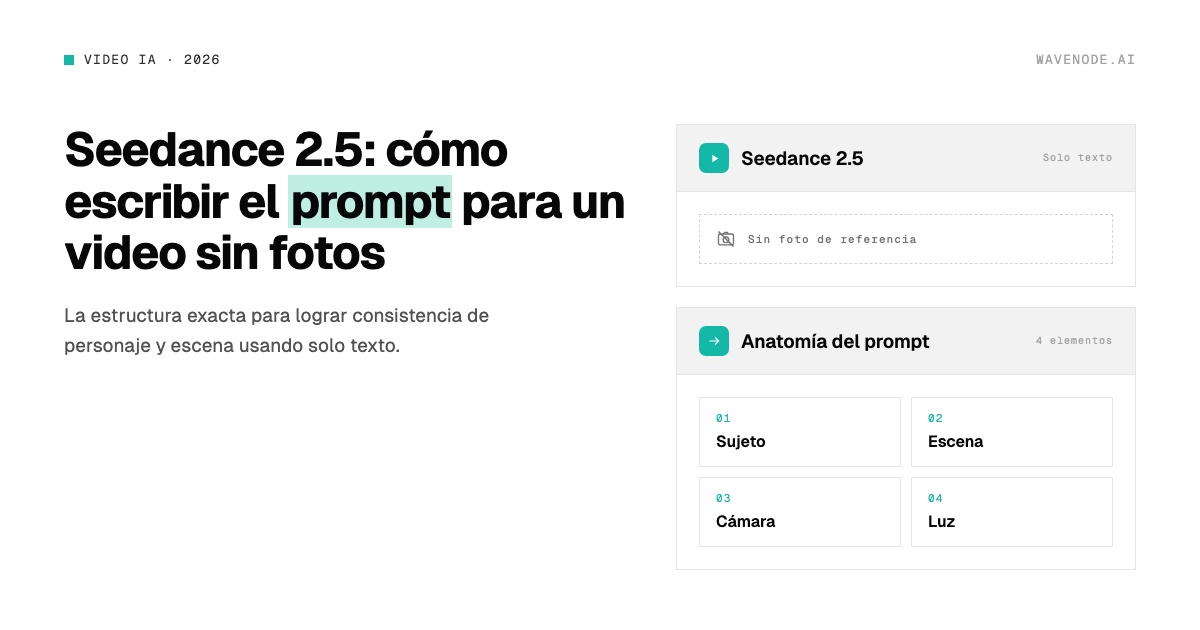
Después de varias iteraciones, llegamos a una estructura de 4 elementos que tratamos casi como una ficha técnica, no como una idea suelta:
- Sujeto — rasgos físicos específicos y repetibles: edad aproximada, cabello, ropa, accesorios. Nada de adjetivos sueltos como "profesional" o "elegante".
- Escena — ubicación, elementos del entorno y momento del día, descritos como si estuvieras dando indicaciones a un director de arte.
- Cámara — tipo de plano y movimiento, en términos de cinematografía (plano medio, dolly-in, estático) que el modelo interpreta de forma mucho más literal que descripciones genéricas.
- Luz — fuente, dirección y temperatura de color. Es el elemento que más rápido delata un video generado cuando se deja al azar.
📊 Patrón que vimos repetirse: entre más adjetivos sensoriales y menos adjetivos vagos ("bonito", "profesional", "atractivo") usamos, más estable fue el resultado entre tomas.
| Elemento | Redacción vaga | Redacción dirigida |
|---|---|---|
| Sujeto | "una mujer profesional" | "mujer de ~30 años, cabello corto castaño, blazer gris, sin joyería" |
| Escena | "oficina moderna" | "oficina con ventanales al fondo, luz de tarde entrando en diagonal, escritorio de madera clara en primer plano" |
| Cámara | "toma bonita" | "plano medio fijo, leve dolly-in de 2 segundos, sin paneo" |
| Luz | "buena iluminación" | "luz natural cálida desde la izquierda, sombras suaves, sin contraluz" |
¿Quieres ver la estructura completa, con el prompt real que usamos? Está en el brief gratuito.
Descargar el brief →Los errores que más rompen el resultado
- Meter dos o tres acciones distintas en un mismo prompt — el modelo prioriza mal cuál es la principal.
- Cambiar el estilo de cámara a mitad de la descripción (empezar "estático" y terminar sugiriendo movimiento).
- Usar adjetivos de evaluación ("bonito", "profesional", "de alta calidad") en vez de descripciones concretas.
- No indicar la duración o el ritmo de la toma, dejando que el modelo decida el pacing por su cuenta.
- Olvidar las restricciones negativas: qué es lo que explícitamente no debe aparecer en el encuadre.
El video de 13 segundos que hicimos con este método
"No hubo cámara. Solo texto." es justo el nombre que le pusimos al brief: documentamos el método completo en 7 pasos que usamos para ese video, incluyendo el prompt exacto —palabra por palabra— y una plantilla para que armes el tuyo siguiendo la misma estructura.
Si quieres ver cómo lo aplicamos nosotros, descarga el brief.
El método en 7 pasos, el prompt exacto y la plantilla para hacer el tuyo. Gratis, dejando tu nombre y correo.
Descárgalo aquí →Cómo lo llevamos a producción con n8n
Escribir el prompt es solo una parte. Para que esto sea un proceso repetible —y no un experimento manual cada vez— automatizamos la generación, la revisión y la publicación con n8n: un flujo dispara la generación con el prompt base, pasa el resultado por una validación y lo deja listo para publicar sin tocar media docena de herramientas distintas.
Preguntas frecuentes sobre Seedance 2.5
¿Qué es Seedance 2.5?
Seedance 2.5 es un modelo de generación de video con IA de Higgsfield que crea clips completos a partir de una descripción de texto, sin necesitar una imagen o foto de referencia como punto de partida.
¿Necesito fotos de referencia para generar un video con IA?
No con Seedance 2.5. A diferencia de los modelos imagen-a-video, genera el clip completo solo con un prompt de texto bien estructurado — el reto se traslada de conseguir la imagen correcta a escribir la descripción correcta.
¿Cómo logro que un personaje se vea igual durante todo el video sin usar una foto?
Describiendo al sujeto como una ficha técnica fija —edad aproximada, rasgos físicos específicos, ropa, accesorios— y repitiendo esos mismos detalles en cada parte del prompt que lo mencione, en lugar de usar adjetivos genéricos que el modelo puede interpretar distinto en cada toma.
¿Quieres el prompt exacto, paso a paso?
Descargar el brief →